
オリジナルの重みとコード
公式の Hugging Face リポジトリには、チェックポイントとモデル カードが含まれています。 GitHub は、デモ、前処理、評価ツールを提供します。このリリースには Apache 2.0 がリストされています。再配布する場合は、ライセンスと該当する通知を保持してください。
新しいタブで、Hugging Face の loongwayX デモを開きます。これは、プロジェクトの情報ページとは異なる、別個のホストされたワークベンチです。
提供された例または機密性のない文書画像から始めます。外部ワークベンチでドキュメントの解析、フィールド抽出、またはページに関する質問を選択します。
読み取り順序、表のセル、数式を元のページと比較します。フィールド抽出の場合は、戻り値が実際にドキュメント内に表示されることを確認してください。
オンにすると外部ワークベンチ ページにアクセス可能になります . これはページの可用性のみをチェックし、推論の成功はチェックしません。スペースがスリープ状態になったり、リクエストをキューに入れたり、失敗した場合は、ローカルのデモ手順を使用してください。 ローカル展開
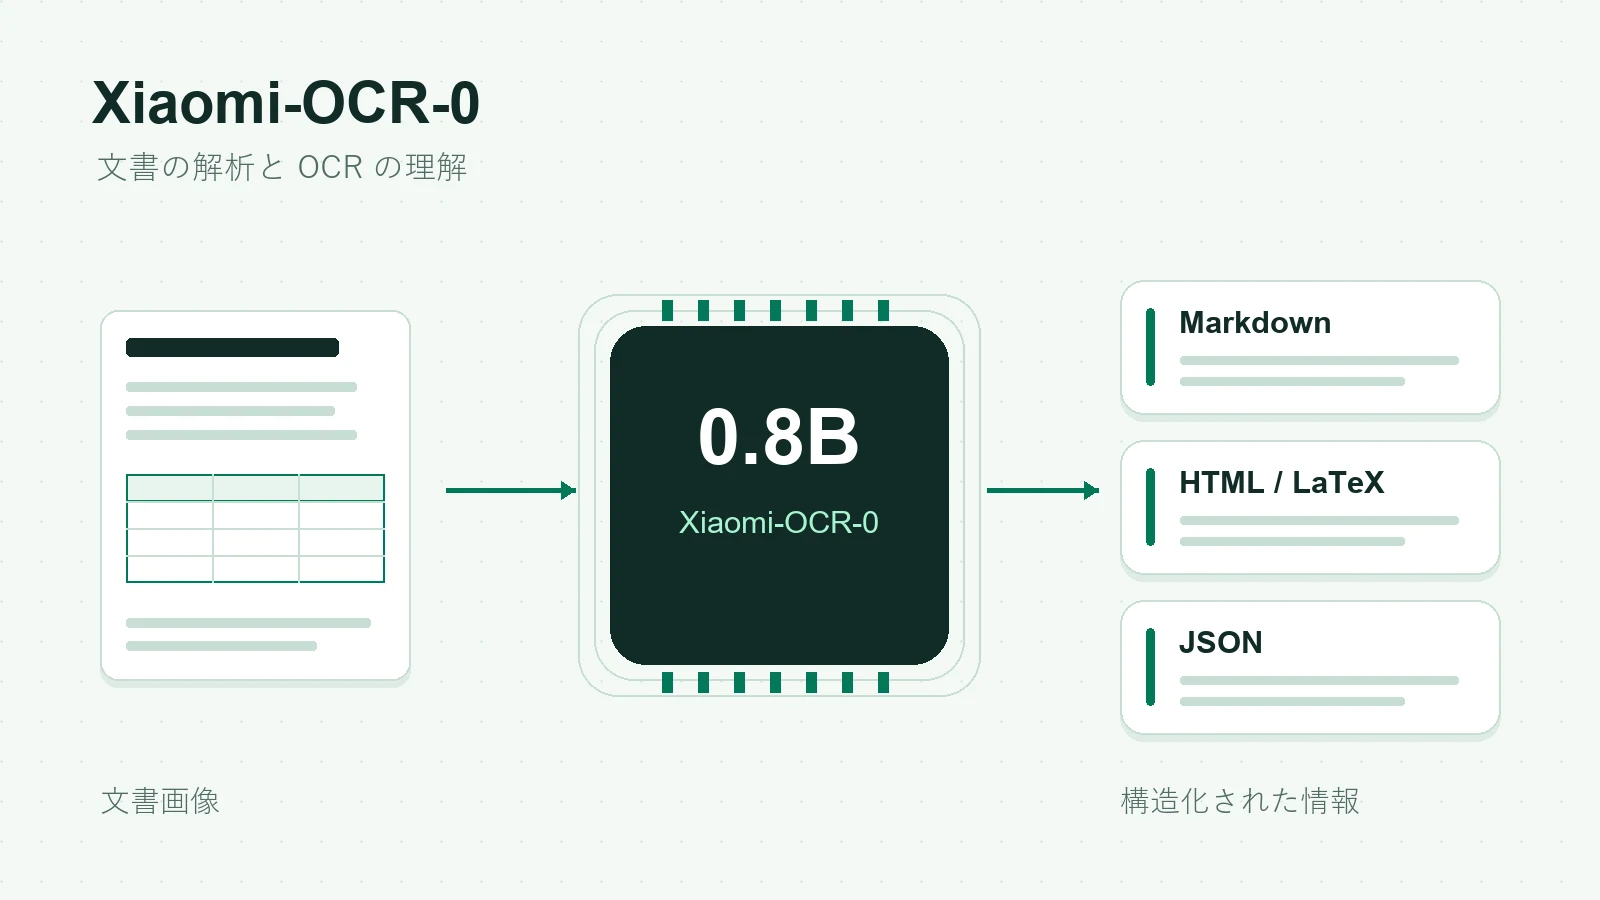
Xiaomi-OCR-0 は文書画像の読み取りと理解に特化しています。プロジェクトは、モデルをページ準備および出力アセンブリ ツールと組み合わせます。
文書ページからテキストと読み上げ順序を復元します。リポジトリのツールは、ページ全体の解析と、通常の印刷レイアウト用の領域ベースのパイプラインをサポートしています。
表の構造と数式を認識します。提供されたワークフローでは、OTSL テーブル出力は Markdown 内で HTML に変換されます。数式は LaTeX を使用します。
日付や合計などの特定のドキュメントフィールドを要求し、KIE ワークフローを通じて構造化された JSON を受け取ります。抽出された値を下流で使用する前に検証します。
表示されているページに基づいて質問してください。 OCR に重点を置いた VQA は、忠実な転写とは別のタスクであり、誤った解釈が生じる可能性があります。
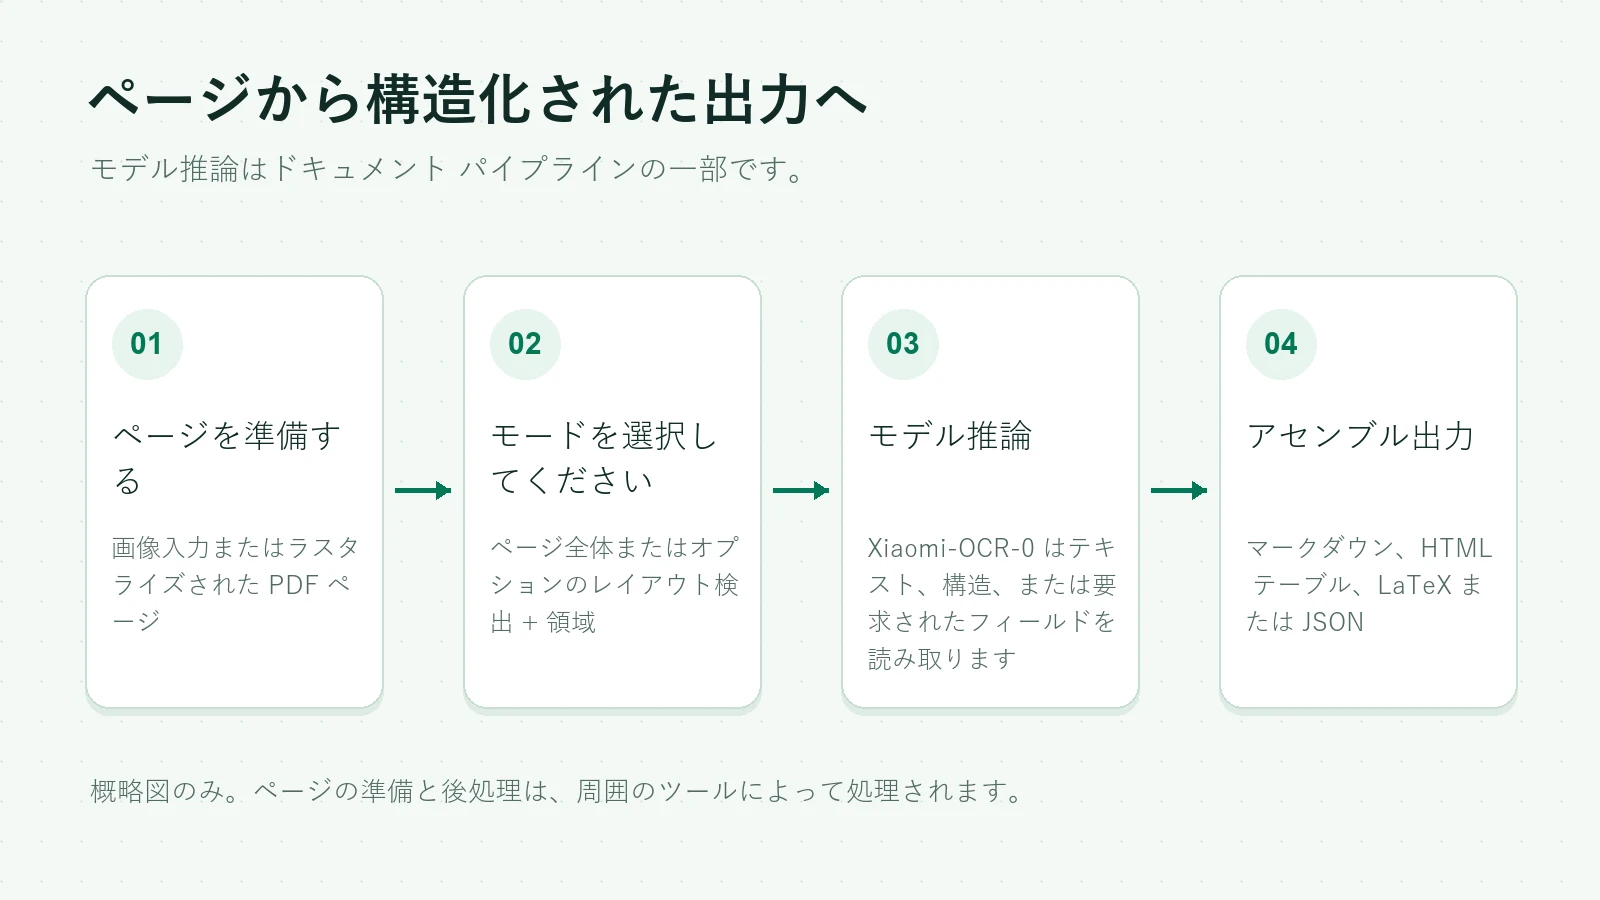
モデルと完全なアプリケーションには異なる責任があります。 PDF ラスタライズ、オプションのレイアウト検出、クロップ順序付け、テーブル変換は、周囲のパイプラインに属します。ベア モデルの呼び出しは、同じ組み立てられたドキュメントを返すと想定すべきではありません。
元のチェックポイントを参照として使用します。ダウンロードする前に、各コミュニティ変換のランタイム、ファイル、ライセンス通知を確認してください。
公式の Hugging Face リポジトリには、チェックポイントとモデル カードが含まれています。 GitHub は、デモ、前処理、評価ツールを提供します。このリリースには Apache 2.0 がリストされています。再配布する場合は、ライセンスと該当する通知を保持してください。
GGUF 変換はコミュニティの成果物です。画像推論には、互換性のあるビジョン プロジェクターも必要です。 Ollama のサポートは実験的であり、変換結果は元のモデルのベンチマーク スコアには含まれません。
主要なルート: Linux、互換性のある NVIDIA GPU および vLLM。以下のコマンドは自分のマシン上で実行され、コピー可能なチュートリアルの例として提供されています。
リポジトリには Python 3.10 以降が必要です。ハードウェアおよび Qwen3_5ForConditionalGeneration アーキテクチャと互換性のある Python バージョン、CUDA/PyTorch ビルド、および vLLM リリースを選択します。ドライバーの要件については、リンクされた vLLM インストール ガイドに従ってください。 0.8B パラメータ数だけでは VRAM の合計使用量を指定するものではありません。画像の解像度、コンテキスト、同時実行性も重要です。
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv-inference
source .venv-inference/bin/activate
python -m pip install --upgrade pip
python -m pip install vllm
vllm serve SeerRay-Lab/Xiaomi-OCR-0 \
  --host 127.0.0.1 --port 8000 --max-model-len 16384
コマンドは、プロジェクトのローカル デモ手順で使用されるチェックポイント識別子である SeerRay-Lab/Xiaomi-OCR-0 を保持します。公式モデルページは xiaomi-research の下で解決されるようになりました。モデルがロードされるまで待ち、サーバーを 127.0.0.1:8000 で実行し続けます。
cd Xiaomi-OCR-0
python3 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt
python demo/server.py --port 8787
2 番目のターミナルで、コマンドを実行する前に、複製されたリポジトリを含む親ディレクトリに移動します。次に、ブラウザで http://127.0.0.1:8787 を開きます。ページ全体モードで提供されたサンプルから始めます。別個のデモ環境では、その依存関係が推論ランタイムから切り離されます。
Qwen3.5 互換の Ollama をインストールし、ローカル サービスを実行し続けます。コミュニティ BF16 パッケージは約 1.8 GB で、ビジョン プロジェクターが含まれています。これらの Linux シェル コマンドは、プロジェクトのデモ前処理を使用します。モデルのプルだけでは OCR ワークフローを構成しません。
ollama pull longwayxu/xiaomi-ocr-0:bf16

# Run from the cloned Xiaomi-OCR-0 directory
python3 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787
通常の印刷ページの場合、領域モードには PaddlePaddle、PaddleX、PP-DocLayoutV3 が追加されます。まず公式の手順に従って互換性のある PaddlePaddle ビルドをインストールし、次にデモ環境でコマンドを実行します。レイアウトの重みは初回使用時にダウンロードされます。実行中のデモを再起動する前に停止してください。シーン テキスト、手書き、または不規則なレイアウトの場合は、ページ全体モードから始めます。
# In the Demo environment, after installing a compatible PaddlePaddle build
python -m pip install -r requirements-paddlex.txt
export XIAOMI_OCR_LAYOUT_DEVICE=cpu
python demo/server.py --port 8787
これらの例は、公開されている手順に対してチェックされており、ここでは GPU デプロイメントとして実行されていません。ローカルの精度、スループット、またはハードウェア メモリの結果は保証されません。モデルの読み込み、アーキテクチャのサポート、またはレイアウトの依存関係が失敗する場合は、プロジェクトのインストール ガイドを参照してください。
発行者の比較表から選択した行。これらは報告された結果であり、この Web サイトによって実行されたテストや現在の OCR モデルの完全なランキングではありません。
| モデル | パラメータ | OmniDocBench v1.6 ↑ | Real5-OmniDocBench ↑ | Wild-OmniDocBench ↑ |
|---|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 93.19 | 87.36 |
| GLM-OCR | 0.9B | 95.22 | 90.32 | 85.08 |
| MinerU2.5-Pro | 1.2B | 95.75 | 88.94 | 87.33 |
| OvisOCR2 | 0.8B | 96.58 | 92.29 | 87.91 |
Xiaomi-OCR-0 の 3 つの解析スコアは、レイアウト検出と領域推論を含む 2 段階のパイプラインを使用します。これらは、単一のページ全体のモデル呼び出しのスコアとして表示されるべきではありません。前処理とスコアリングの設定については、評価パイプラインを参照してください。
同じベンチマークとバージョン内の結果を比較します。選択したテーブルでは、レイテンシ、展開コスト、または GGUF/Ollama の精度が確立されていません。モデルを選択する前に、独自のページを使用して、読み取り順序、表、数式、およびフィールド抽出を評価します。
チェックしたソース:
現在の手順については、元のモデル カード、レポート、リポジトリを使用してください。このページには、日付付きの参照スナップショットが記録されます。ランタイムの互換性と外部デモの利用可能性は変更される可能性があります。