
원래 가중치 및 코드
공식 Hugging Face 저장소에는 체크포인트와 모델 카드가 포함되어 있습니다. GitHub는 데모, 전처리 및 평가 도구를 제공합니다. 릴리스에는 Apache 2.0이 나열되어 있습니다. 재배포할 때 라이센스와 해당 고지 사항을 유지하십시오.
오픈 소스 OCR · 0.8B 매개변수
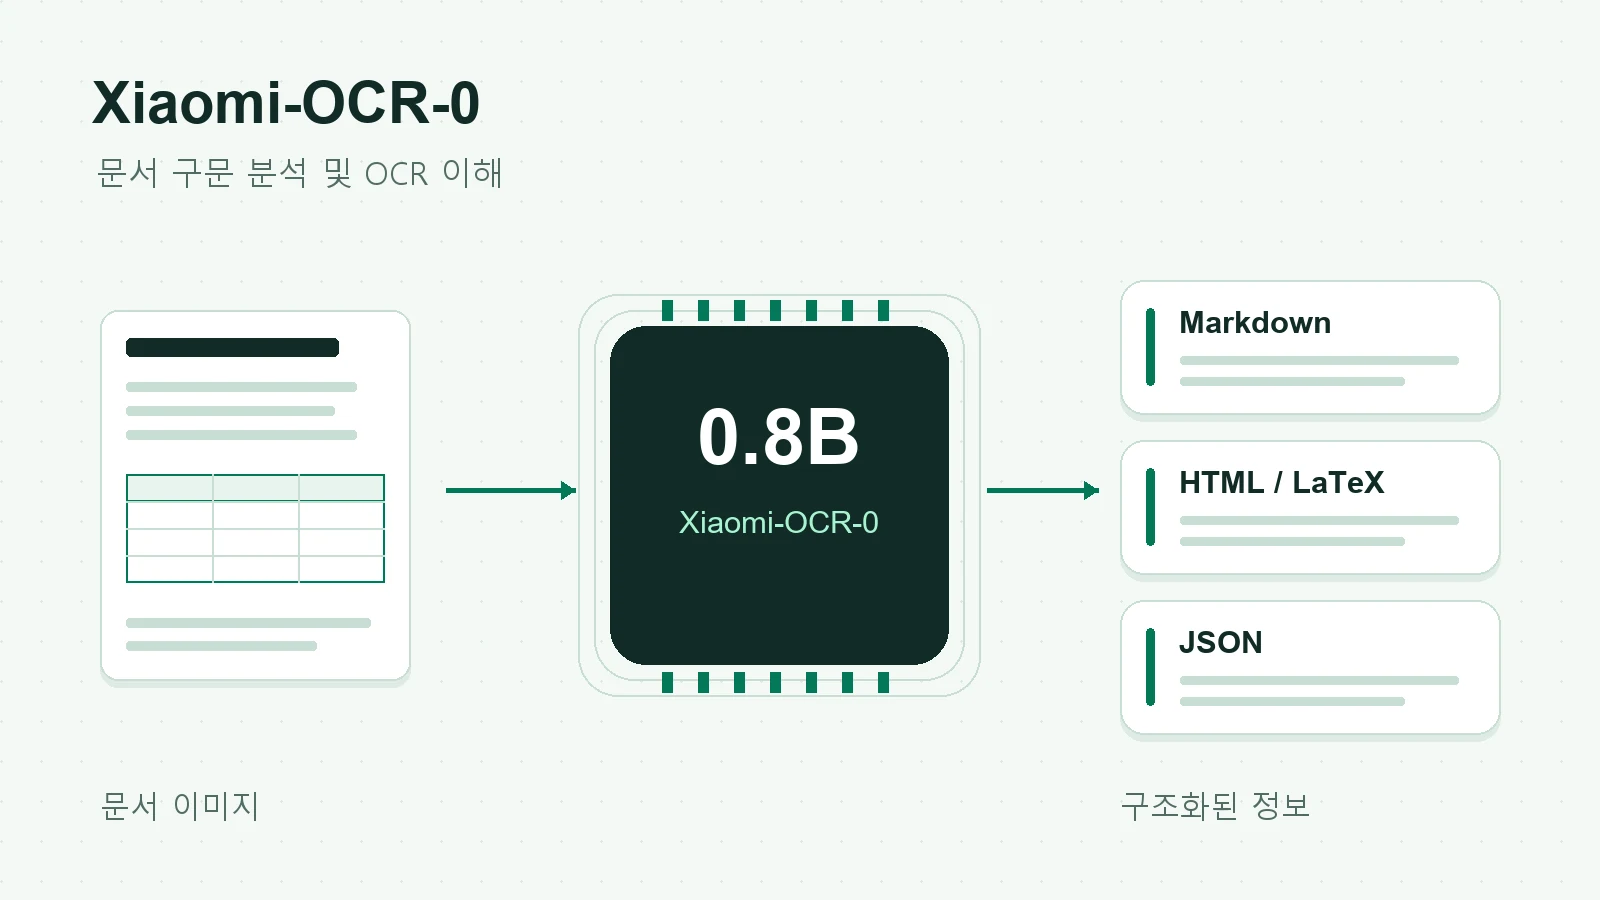
문서 구문 분석 및 OCR 이해를 위한 Xiaomi의 컴팩트 비전 언어 모델을 살펴보세요. 온라인 데모, 모델 중량, 기술 보고서 및 실용적인 현지 배포 가이드를 한 곳에서 찾아보세요.
독립적인 리소스 가이드입니다. 데모는 외부 Hugging Face Space에서 실행됩니다. 이 페이지에서는 문서를 업로드하거나 처리하지 않습니다.
확인된 소스:
새 탭에서 Hugging Face의 loongwayX 데모를 엽니다. 이는 프로젝트 정보 페이지와 별개로 호스팅되는 별도의 워크벤치입니다.
제공된 예제나 민감하지 않은 문서 이미지로 시작하세요. 외부 워크벤치에서 문서 구문 분석, 필드 추출 또는 페이지에 대한 질문을 선택하세요.
읽는 순서, 표 셀, 수식을 원본 페이지와 비교하세요. 필드 추출의 경우 반환된 값이 실제로 문서에 나타나는지 확인하세요.
선택하면 외부 워크벤치 페이지에 액세스할 수 있습니다. . 이는 성공적인 추론이 아닌 페이지 가용성만 확인합니다. Space가 대기 중이거나, 요청을 대기열에 넣거나, 실패하는 경우 로컬 데모 지침을 사용하세요. 로컬 배포
Xiaomi-OCR-0은 문서 이미지를 읽고 이해하는 데 특화되어 있습니다. 이 프로젝트는 모델을 페이지 준비 및 출력 어셈블리 도구와 결합합니다.
문서 페이지에서 텍스트 및 읽기 순서를 복구합니다. 저장소의 도구는 전체 페이지 구문 분석과 일반 인쇄 레이아웃을 위한 지역 기반 파이프라인을 지원합니다.
테이블 구조와 수학적 표현을 인식합니다. 제공된 워크플로에서 OTSL 테이블 출력은 Markdown 내에서 HTML로 변환됩니다. 수식은 LaTeX를 사용합니다.
날짜나 합계 등 특정 문서 필드를 요청하고 KIE 워크플로를 통해 구조화된 JSON을 받습니다. 다운스트림을 사용하기 전에 추출된 값의 유효성을 검사하십시오.
보이는 페이지에 기반을 두고 질문하세요. OCR 중심 VQA는 충실한 전사와 별개의 작업이며 잘못된 해석을 생성할 수 있습니다.
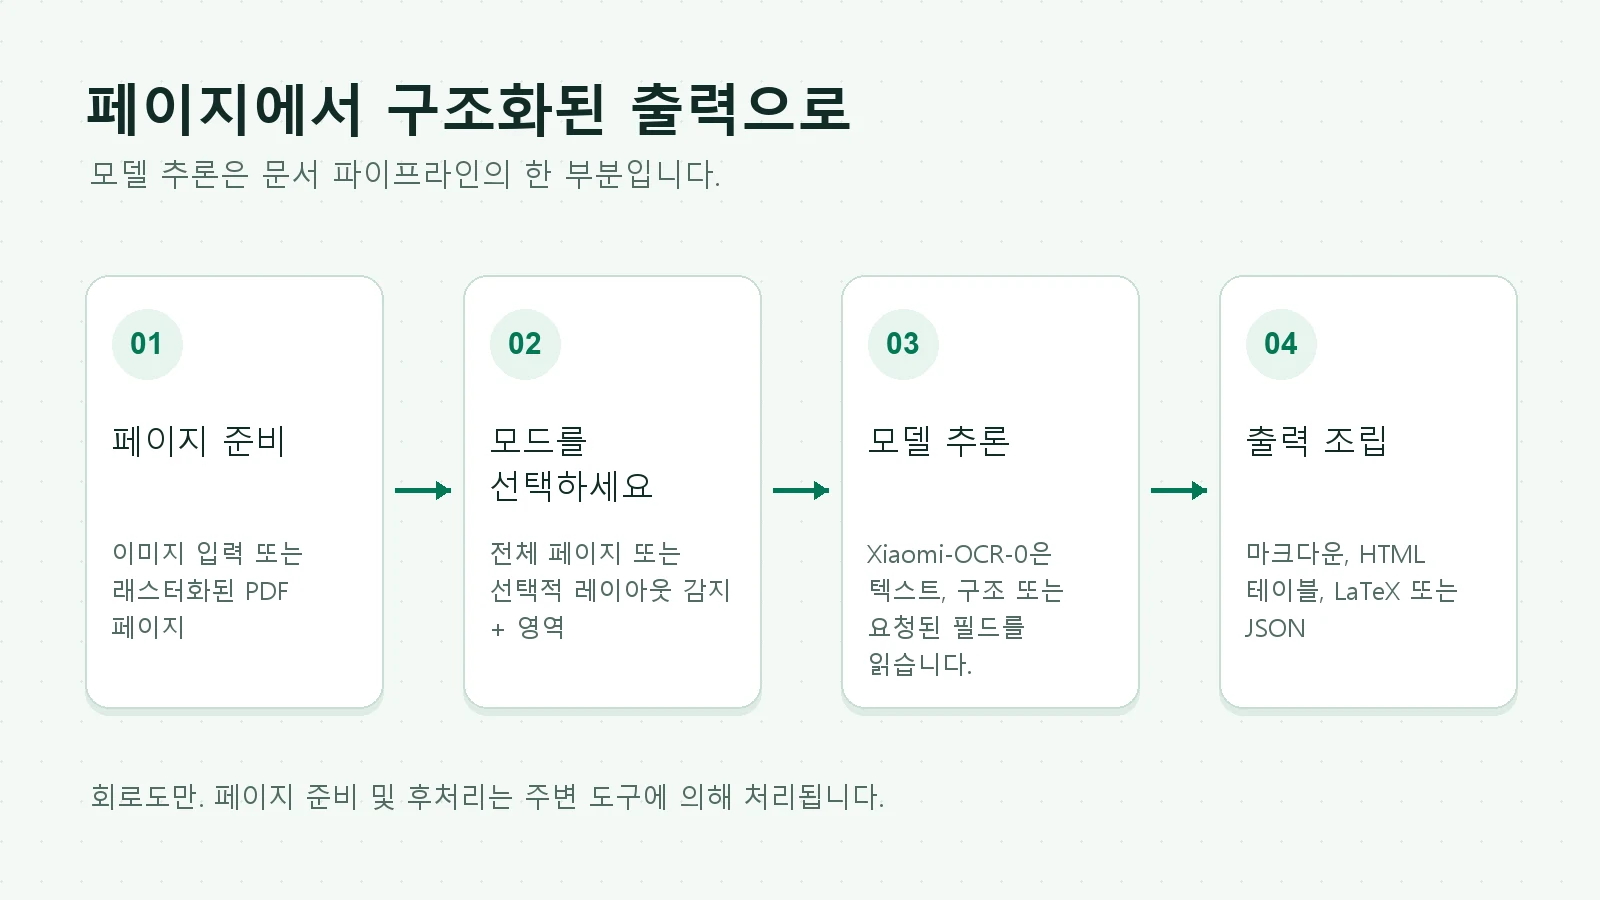
모델과 전체 애플리케이션의 책임은 다릅니다. PDF 래스터화, 선택적 레이아웃 감지, 자르기 순서 및 테이블 변환은 주변 파이프라인에 속합니다. 베어 모델 호출이 동일한 조합 문서를 반환한다고 가정하면 안 됩니다.
원본 체크포인트를 참조로 사용하세요. 다운로드하기 전에 각 커뮤니티 전환의 런타임, 파일 및 라이선스 공지를 확인하세요.
공식 Hugging Face 저장소에는 체크포인트와 모델 카드가 포함되어 있습니다. GitHub는 데모, 전처리 및 평가 도구를 제공합니다. 릴리스에는 Apache 2.0이 나열되어 있습니다. 재배포할 때 라이센스와 해당 고지 사항을 유지하십시오.
GGUF 변환은 커뮤니티 아티팩트입니다. 이미지 추론에는 호환되는 비전 프로젝터도 필요합니다. Ollama 지원은 실험적이며 변환 결과는 원래 모델의 벤치마크 점수에 포함되지 않습니다.
기본 경로: Linux, 호환되는 NVIDIA GPU 및 vLLM. 아래 명령은 사용자의 컴퓨터에서 실행되며 복사 가능한 튜토리얼 예제로 제공됩니다.
저장소에는 Python 3.10 이상이 필요합니다. 하드웨어 및 Qwen3_5ForConditionalGeneration 아키텍처와 호환되는 Python 버전, CUDA/PyTorch 빌드 및 vLLM 릴리스를 선택하세요. 드라이버 요구 사항은 링크된 vLLM 설치 가이드를 따르세요. 0.8B 매개변수 수만으로는 총 VRAM 사용을 지정하지 않습니다. 이미지 해상도, 컨텍스트 및 동시성도 중요합니다.
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv-inference
source .venv-inference/bin/activate
python -m pip install --upgrade pip
python -m pip install vllm
vllm serve SeerRay-Lab/Xiaomi-OCR-0 \
  --host 127.0.0.1 --port 8000 --max-model-len 16384
이 명령은 프로젝트의 로컬 데모 지침에 사용되는 체크포인트 식별자인 SeerRay-Lab/Xiaomi-OCR-0을 유지합니다. 공식 모델 페이지는 이제 Xiaomi-research에서 해결됩니다. 모델이 로드될 때까지 기다리고 서버를 127.0.0.1:8000에서 계속 실행합니다.
cd Xiaomi-OCR-0
python3 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt
python demo/server.py --port 8787
두 번째 터미널에서 명령을 실행하기 전에 복제된 저장소가 포함된 상위 디렉터리로 이동합니다. 그런 다음 브라우저에서 http://127.0.0.1:8787를 엽니다. 전체 페이지 모드에서 제공된 샘플로 시작합니다. 별도의 데모 환경은 추론 런타임과 별도로 종속성을 유지합니다.
Qwen3.5 호환 Ollama를 설치하고 로컬 서비스를 계속 실행하세요. 커뮤니티 BF16 패키지는 약 1.8GB이며 비전 프로젝터를 포함합니다. 이러한 Linux 셸 명령은 프로젝트의 데모 전처리를 사용합니다. 모델 풀만으로는 OCR 작업흐름을 구성하지 않습니다.
ollama pull longwayxu/xiaomi-ocr-0:bf16

# Run from the cloned Xiaomi-OCR-0 directory
python3 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787
일반 인쇄 페이지의 경우 지역 모드는 PaddlePaddle, PaddleX 및 PP-DocLayoutV3을 추가합니다. 먼저 공식 지침을 사용하여 호환되는 PaddlePaddle 빌드를 설치한 다음 데모 환경에서 명령을 실행하세요. 처음 사용할 때 레이아웃 가중치가 다운로드됩니다. 실행 중인 데모를 다시 시작하기 전에 중지하십시오. 장면 텍스트, 손글씨 또는 불규칙한 레이아웃의 경우 전체 페이지 모드로 시작하세요.
# In the Demo environment, after installing a compatible PaddlePaddle build
python -m pip install -r requirements-paddlex.txt
export XIAOMI_OCR_LAYOUT_DEVICE=cpu
python demo/server.py --port 8787
이러한 예제는 게시된 지침과 비교하여 확인되었으며 여기에서는 GPU 배포로 실행되지 않았습니다. 로컬 정확도, 처리량 또는 하드웨어 메모리 결과는 주장되지 않습니다. 모델 로딩, 아키텍처 지원 또는 레이아웃 종속성이 실패하는 경우 프로젝트 설치 가이드를 참조하세요.
게시자의 비교표에서 선택된 행입니다. 이는 보고된 결과이며, 이 웹사이트에서 수행한 테스트나 현재 OCR 모델의 전체 순위가 아닙니다.
| 모델 | 매개변수 | OmniDocBench v1.6 ↑ | Real5-OmniDocBench ↑ | Wild-OmniDocBench ↑ |
|---|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 93.19 | 87.36 |
| GLM-OCR | 0.9B | 95.22 | 90.32 | 85.08 |
| MinerU2.5-Pro | 1.2B | 95.75 | 88.94 | 87.33 |
| OvisOCR2 | 0.8B | 96.58 | 92.29 | 87.91 |
Xiaomi-OCR-0의 세 가지 구문 분석 점수는 레이아웃 감지 및 지역 추론을 포함하는 2단계 파이프라인을 사용합니다. 단일 전체 페이지 모델 호출에 대한 점수로 표시되어서는 안 됩니다. 전처리 및 채점 설정은 평가 파이프라인을 참조하세요.
동일한 벤치마크 및 버전 내에서 결과를 비교하세요. 선택한 테이블은 대기 시간, 배포 비용 또는 GGUF/Ollama 정확성을 설정하지 않습니다. 모델을 선택하기 전에 자신의 페이지를 사용하여 읽기 순서, 표, 공식 및 필드 추출을 평가하십시오.
확인된 소스:
최신 지침을 보려면 원본 모델 카드, 보고서 및 저장소를 사용하십시오. 이 페이지는 날짜가 지정된 참조 스냅샷을 기록합니다. 런타임 호환성 및 외부 데모 가용성은 변경될 수 있습니다.