
原始权重与官方代码
官方 Hugging Face 仓库提供模型权重与模型卡,GitHub 提供 Demo、预处理和评测工具。项目标注 Apache 2.0 许可证;再分发时应保留许可证与适用声明。
开源 OCR · 0.8B 参数
了解小米面向文档解析与 OCR 理解的轻量级视觉语言模型。在这里找到在线试用入口、模型权重、技术报告和本地部署方法。
本站为独立资源指南。在线 Demo 运行于外部 Hugging Face Space,本页面不上传或处理你的文档。
资料核实日期:
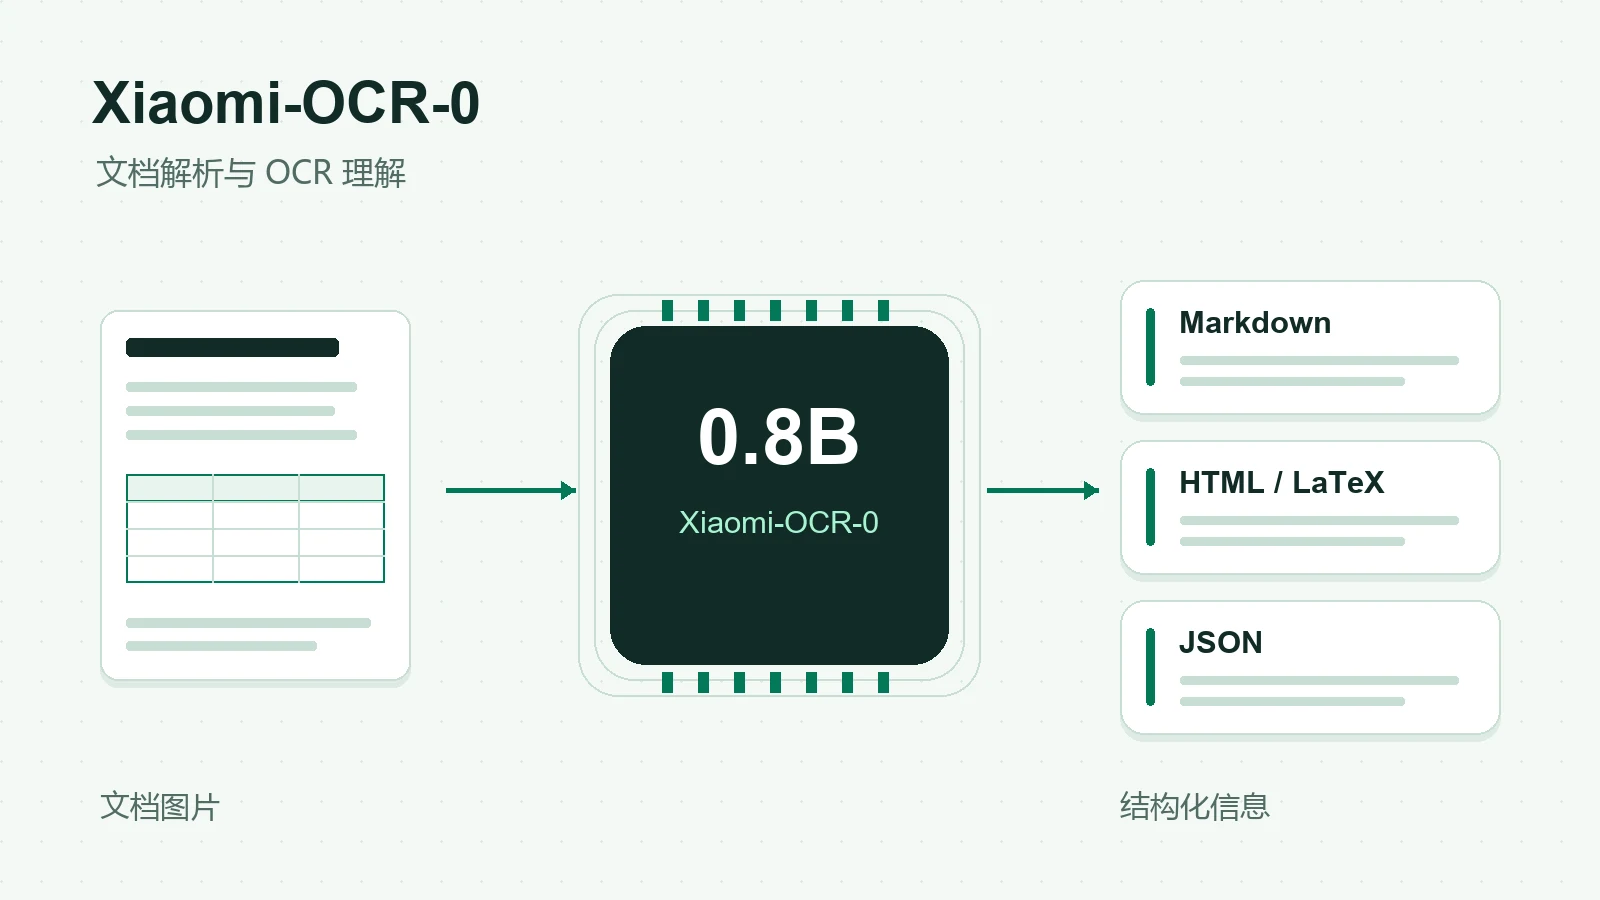
在新标签页打开 loongwayX 提供的 Hugging Face Demo。它是独立的托管工作台,与官方项目介绍页不同。
先使用工作台提供的样例,或不含敏感信息的文档图片。在外部工作台选择文档解析、字段提取,或针对页面内容提问。
对照原图检查阅读顺序、表格单元格与公式;提取字段时,确认返回的数值确实出现在文档中。
外部工作台页面可访问,检查日期: . 本次仅检查页面可访问性,未验证推理成功。若 Space 休眠、排队或报错,可按以下教程运行本地 Demo: 本地部署
Xiaomi-OCR-0 专注于文档图片的识别与理解,项目还提供了页面准备和结果组装工具。
识别页面文字并恢复阅读顺序。配套工具支持整页解析,也支持面向规则印刷版面的区域解析流程。
识别表格结构与数学表达式。项目流程将模型输出的 OTSL 表格转换为 Markdown 内嵌的 HTML 表格,公式使用 LaTeX 表达。
通过 KIE 流程指定日期、合计等字段,并获取结构化 JSON。将提取值用于后续业务前,仍需核对原文。
围绕页面中可见的文字与内容提问。OCR 问答与逐字转录是不同任务,对文档的解释仍可能出错。
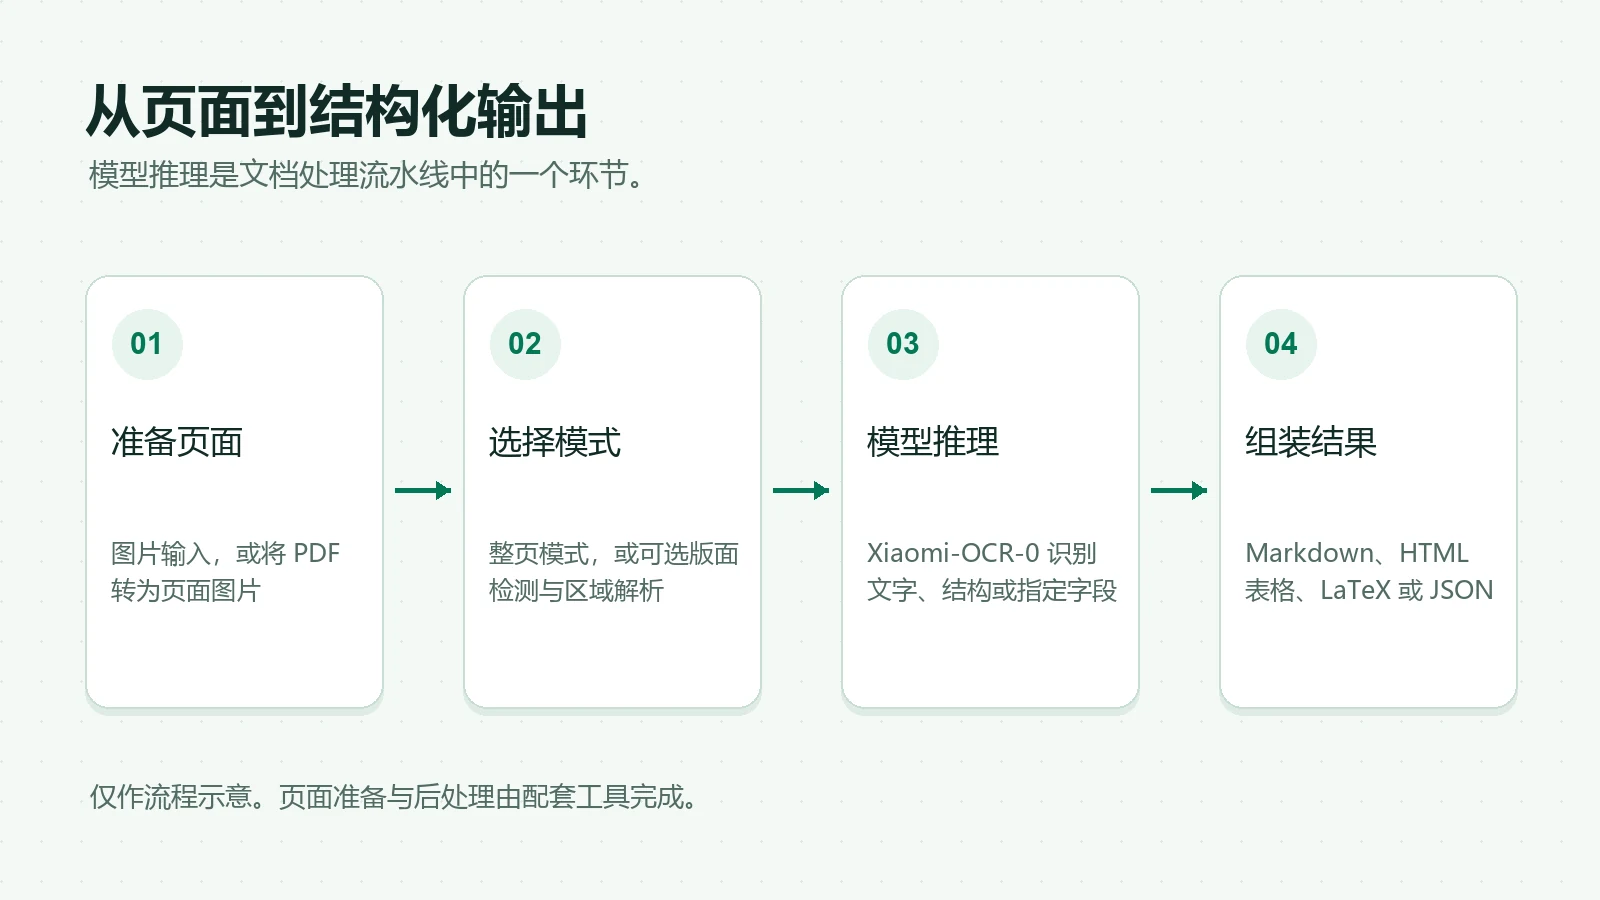
模型与完整应用各有分工。PDF 转图片、可选版面检测、裁切区域排序和表格转换属于配套流程,不能直接假定单次模型调用会返回同样组装完成的文档。
以原始权重为参考基准。下载社区转换文件前,检查对应运行时、配套文件与许可证说明。
官方 Hugging Face 仓库提供模型权重与模型卡,GitHub 提供 Demo、预处理和评测工具。项目标注 Apache 2.0 许可证;再分发时应保留许可证与适用声明。
GGUF 转换由社区提供,图片推理还需要兼容的视觉投影文件。Ollama 支持属于实验方案,原始模型的评测分数不能直接作为转换版本的效果证明。
主方案采用 Linux、兼容的 NVIDIA GPU 与 vLLM。下列命令是在你自己的设备上运行的教程示例,可直接复制。
项目要求 Python 3.10 及以上版本。请根据硬件选择兼容的 Python、CUDA/PyTorch 与 vLLM 版本,并确认运行时支持 Qwen3_5ForConditionalGeneration 架构。驱动要求见下方 vLLM 安装文档。0.8B 参数量不等于总显存占用,图片分辨率、上下文长度和并发也会影响内存需求。
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv-inference
source .venv-inference/bin/activate
python -m pip install --upgrade pip
python -m pip install vllm
vllm serve SeerRay-Lab/Xiaomi-OCR-0 \
  --host 127.0.0.1 --port 8000 --max-model-len 16384
命令保留项目本地 Demo 教程使用的 SeerRay-Lab/Xiaomi-OCR-0 标识;官方模型页现已跳转至 xiaomi-research 命名空间。等待权重加载完成,并保持 127.0.0.1:8000 上的推理服务运行。
cd Xiaomi-OCR-0
python3 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt
python demo/server.py --port 8787
在第二个终端中,先进入包含克隆仓库的父目录,再执行命令。随后用浏览器打开 http://127.0.0.1:8787,先使用内置样例测试整页模式。Demo 使用独立虚拟环境,避免与推理运行时混装依赖。
安装支持 Qwen3.5 的 Ollama,并保持本地服务运行。社区 BF16 包约 1.8 GB,包含视觉投影文件。下列 Linux Shell 命令通过项目 Demo 复用 OCR 预处理,单独拉取模型并不能完成整个工作流配置。
ollama pull longwayxu/xiaomi-ocr-0:bf16

# Run from the cloned Xiaomi-OCR-0 directory
python3 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787
规则印刷页面可使用区域模式,需额外安装 PaddlePaddle、PaddleX 与 PP-DocLayoutV3。先按官方说明安装兼容的 PaddlePaddle,再在 Demo 虚拟环境中执行下列命令。版面模型首次使用时下载;重启前先停止已运行的 Demo。场景文字、手写或不规则版面建议先使用整页模式。
# In the Demo environment, after installing a compatible PaddlePaddle build
python -m pip install -r requirements-paddlex.txt
export XIAOMI_OCR_LAYOUT_DEVICE=cpu
python demo/server.py --port 8787
示例已与项目公开说明核对,但本站未实际执行 GPU 部署,也未测量本地准确率、吞吐量或显存。若遇到模型加载、架构支持或版面依赖问题,请查阅项目安装文档。
以下选取发布方对比表中的部分模型。这些是公开报告结果,并非本站实测,也不构成当前全部 OCR 模型的完整排名。
| 模型 | 参数量 | OmniDocBench v1.6 ↑ | Real5-OmniDocBench ↑ | Wild-OmniDocBench ↑ |
|---|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 93.19 | 87.36 |
| GLM-OCR | 0.9B | 95.22 | 90.32 | 85.08 |
| MinerU2.5-Pro | 1.2B | 95.75 | 88.94 | 87.33 |
| OvisOCR2 | 0.8B | 96.58 | 92.29 | 87.91 |
Xiaomi-OCR-0 的这三项解析分数采用两阶段流程,包含版面检测与区域推理,不能当作一次整页模型调用的成绩。预处理与评分设置请参阅评测流水线。
应在同一基准及版本内比较分数。该表不说明延迟、部署成本或 GGUF/Ollama 转换效果。选型时,请使用自己的页面分别检查阅读顺序、表格、公式与字段提取。
资料核实日期:
最新说明以原始模型卡、技术报告与仓库为准。本页记录有日期的资料快照,运行时兼容性和外部 Demo 状态可能变化。